寫了 robots.txt,AI Bot 就進得來嗎?還有第二扇門
robots.txt 只是告示牌,擋住 GPTBot、ClaudeBot 的是 CDN 與 WAF。逐家比對官方文件:Cloudflare 9/15 起新網域在有廣告的頁面預設擋 Training 與 Agent,AWS WAF 的 CategoryAI 規則連已驗證的 AI bot 都擋,Vercel 與 Bunny 預設不動作。要確認爬蟲是否進得來,看 CDN 後台與 log 的回應碼。
重點摘要
- robots.txt 沒有強制力,RFC 9309 明寫這些規則「不是一種存取授權」。真正決定 GPTBot、OAI-SearchBot、ClaudeBot 讀不讀得到頁面的是 CDN 與 WAF,被擋時對方收到的是 403、406 或一張挑戰頁。
- AI 爬蟲的預設待遇各平台差很多:Cloudflare 從 2026 年 9 月 15 日起,新網域在有廣告的頁面預設擋 Training 與 Agent;AWS WAF Bot Control 的 CategoryAI 規則預設 Block,連已驗證的 AI bot 也擋;Vercel 的 AI bots 規則集與 Bunny Shield 新區域的 AI 類別預設不動作;Google Cloud Armor 與 Azure Front Door 查不到 AI 爬蟲專屬規則。
- 要確認 AI 爬蟲是否進得來,看 CDN 後台的實際請求數與 log 裡的回應碼:200 代表請求成功進入,403、406、429 或挑戰頁代表被 CDN 或 WAF 擋下,只讀取 /robots.txt 代表被 robots.txt 擋下。
robots.txt 寫了歡迎光臨,AI 爬蟲不一定進得來。
我把九家 CDN 與雲端 WAF 的官方文件逐一翻過,「AI 爬蟲預設能不能進門」這題,各家答案落差大到不能拿同一張檢查清單去套。AWS WAF 的 Bot Control 一加上去,CategoryAI 規則預設就擋,連已驗證的 AI bot 也照擋;Cloudflare 9 月 15 日又要改一次新網域的預設;Google Cloud Armor 和 Azure Front Door 則查不到 AI 爬蟲專屬的規則。
想像商場裡的一間店。走道上立著告示牌寫「歡迎光臨,往這邊走」,客人照著走到門前,伸手一推,門是鎖的。robots.txt 就是那塊告示牌,它表達的是同意;真正決定能不能走進來的是門鎖,而門鎖裝在 CDN 和 WAF 那一層。
同意跟開門是兩件事。
robots.txt 是告示牌,連標準本身都說它不是授權
robots.txt 沒有強制力。定義它的標準 RFC 9309 明確提到,這些規則「不是一種存取授權」(not a form of access authorization)。Cloudflare 的 managed robots.txt 文件也寫,遵守 robots.txt 是自願的。
守不守,看對方。有幾隻 bot 在自家官方文件裡就先講明了:
- OpenAI:ChatGPT-User 由使用者觸發,robots.txt 規則「可能不適用」。
- Perplexity:Perplexity-User「一般會忽略 robots.txt」。
- Meta:Meta-ExternalFetcher 可能繞過 robots.txt。
- Anthropic:旗下 bot 會遵守 robots.txt 的 do not crawl 指令。
同一個「進不來」,在 HTTP 層長得完全不一樣。被 robots.txt 擋,守規矩的 bot 讀完告示自己轉身,log 裡只會看到它讀了一次 /robots.txt。被 CDN 擋,bot 是真的來敲了門,收到的是 403、406 或一張挑戰頁。
Anthropic 的文件裡還有一句反方向的提醒:用封鎖 IP 的方式擋它的 bot「可能無法正確運作」,因為這樣它就讀不到你的 robots.txt。門鎖鎖得太早,連告示牌上寫什麼都傳不過去。
AI bot 分三種,各家 CDN 的分類方式不同
AI bot 大致有三種工作:抓內容去訓練模型、支撐 AI 搜尋、使用者當下觸發去讀某一頁。擋掉哪一種,後果完全不同,偏偏各家 CDN 的分類方式並不一致。
Cloudflare 的 bot 對照表是這樣標的:
- AI Crawler:GPTBot、ClaudeBot、Meta-ExternalAgent。
- AI Search:OAI-SearchBot、Claude-SearchBot、PerplexityBot、Applebot。
- AI Assistant:ChatGPT-User、Claude-User、Perplexity-User、Meta-ExternalFetcher。
- Search Engine:Googlebot、BingBot。
擋掉 GPTBot 是不給訓練,擋掉 OAI-SearchBot 是從 ChatGPT 的搜尋結果裡消失,OpenAI 的文件把這兩件事分得很清楚。
換一家平台,格子就不一樣:
| 平台 | AI bot 分類方式(官方文件) |
|---|---|
| Cloudflare | Search、Agent、Training 三格,每格可設放行、全站擋、只擋有廣告的頁面 |
| Fastly | AI Crawler 與 AI Fetcher 兩類,各分 verified 與 suspected,共四個 signal |
| Bunny.net | AI Scraper(抓內容訓練或餵模型)與 AI Tool(使用者觸發的 AI agent)兩類 |
| AWS WAF | 一條 CategoryAI 規則涵蓋 AI bot,要分開處理得用 bot 名稱標籤自己寫規則 |
| Azure Front Door | Bot Manager 只有 Good、Bad、Unknown,沒有 AI 分類 |
分類方式決定了設定的難易度。以「放行搜尋、封鎖訓練」為例:Cloudflare 已把 AI bot 分成 Search、Agent、Training 三格,在後台為三格各選一個動作即可;AWS WAF 只有一條 CategoryAI 規則涵蓋所有 AI bot,要區分搜尋與訓練,必須依 bot 名稱標籤另外撰寫規則。
還有兩個名字只存在告示牌上。Google-Extended 沒有自己的 user agent,只在 robots.txt 裡當控制開關,而且不影響 Google 搜尋收錄;Applebot-Extended 官方也寫明它不爬網頁。Cloudflare 的 robots.txt 設定(managed robots.txt)開啟後,會在 robots.txt 最前面加入 Google-Extended 與 Applebot-Extended 的 Disallow: /,但這個開關改的仍是 robots.txt,Cloudflare 文件也註明遵守與否是自願的。這兩個名字沒有對應的爬取請求,在 CDN 與 WAF 那層沒有可以封鎖的對象。
九家平台的門鎖,預設值從「預設就擋」到「查不到這功能」都有
官方文件寫到的預設值可以分成四種:預設就擋、預設不動作、要自己加但加了就擋、查不到 AI 專屬功能。「預設」兩個字各家指的也不同,有的講新網域,有的講新區域,既有資源多半沒寫,下表凡是官方沒寫的都標「官方未寫」。
| 平台 | 功能名稱 | 預設值(官方文件) | 設定位置 | 擋掉時回什麼 |
|---|---|---|---|---|
| Cloudflare | AI bot policies(Search/Agent/Training)、AI Crawl Control | 2025-07-01 起新網域預設擋 AI 爬蟲;2026-09-15 起新網域改為有廣告的頁面擋 Training 與 Agent、Search 放行。既有網域:官方只寫新網域套新預設,未寫會自動改 | Security Settings → Configure AI bot policies | 403;付費方案可設 402(pay per crawl);挑戰頁帶 cf-mitigated: challenge header |
| Fastly | Bot Management 的 AI bot signals(VERIFIED-BOT.AI-CRAWLER 等四個) | 官方未寫預設值。Bot Management 需付費、Essentials 方案不含,要把開關切到 On;signal 是標籤,要搭配規則才會動作 | Security → Next-Gen WAF → Rules,或用 VCL | Next-Gen WAF 封鎖預設回 406,可改 301、302、400 到 599;官方 VCL 範例回 402 |
| Akamai | Bot Manager(Premier)、Content Protector;Attack Insights 加購可偵測已知 AI bot 流量暴增 | 公開文件查不到 bot 類別的出廠預設動作;官方建議先用 monitor 模式跑幾週 | Control Center、Bot Manager API、Terraform(細部文件需登入) | 動作有 monitor、allow、deny、tarpit、challenge;deny 的狀態碼公開文件查不到 |
| AWS CloudFront + WAF | Bot Control 的 CategoryAI 規則 | Bot Control 要自己加、另外收費;加了之後 CategoryAI 預設 Block,已驗證與未驗證都擋。4.0 版起通過 Web Bot Auth 驗證的 bot 不會被 Category 規則比中,但版本要手動選 | WAF web ACL 加入 AWSManagedRulesBotControlRuleSet | 預設 403;Challenge 回 202;CAPTCHA 回 405;Monetize 動作回 402(限 CloudFront) |
| Google Cloud CDN + Cloud Armor | 查不到 AI 爬蟲專屬規則;bot management 靠 reCAPTCHA 整合 | 沒有 AI 預設值;要自己寫 security policy 規則,可比對 User-Agent | Cloud Armor security policy | deny 規則可回 403、404 或 502 |
| Azure Front Door + WAF | Bot Manager 規則集(1.1 版限 Premium) | 沒有 AI 分類。規則集要自己加進 WAF policy;啟用後 Bad 擋、Good 放、Unknown 只記錄。GPTBot 等落在哪一類,官方未寫 | WAF policy → Managed rules → Additional rule set | 預設 403「The request is blocked.」;速率限制回 429 |
| Vercel | AI bots managed ruleset、Bot Protection managed ruleset | 兩者預設 inactive:AI bots 後台標示 Allow,Bot Protection 標示 Off | 專案層級套用;AI bots 可選 log 或 deny,Bot Protection 可選 log 或 challenge | deny 擋掉所有被判定為 AI bot 的流量;Bot Protection 對非瀏覽器流量發挑戰、排除 verified bots;狀態碼官方未寫 |
| Netlify | User Agent Blocker 擴充(Edge Function) | 要手動安裝,一次只能在一個專案啟用;清單不含所有 AI 爬蟲;沒找到原生設定 | Extensions 安裝後到專案啟用 | 官方未寫狀態碼 |
| Bunny.net | Bunny Shield Verified Bots(2026-07-30 上線),AI Scraper 與 AI Tool 兩類 | 新 Shield Zone:AI Scraper、AI Tool 預設 No action,辨識但不特別放行也不擋,照一般流量處理。既有 Zone:官方未寫 | 每個 Shield Zone 各自設定,或走 API | Block 在邊緣回 403 |
AWS 是這幾家裡唯一把「連已驗證的 AI bot 都擋」寫進預設規則的雲端 WAF。它其他的 Category 規則只擋未驗證的 bot,唯獨 CategoryAI 例外,而文件列出的 AI bot 標籤包含 ClaudeBot、PerplexityBot 與 OpenAI 的組織標籤。站台放在 CloudFront 後面、又加了 Bot Control 的,要回頭確認這條規則有沒有把想放行的搜尋 bot 一起擋掉。
那要怎麼確認真的爬蟲進得來?
看兩個地方:CDN 後台與 log。
第一步是 CDN 後台,這裡記錄的是爬蟲實際來過的請求。Cloudflare 在 AI Crawl Control 的 Crawlers 分頁,每隻 AI 爬蟲放行與沒成功的請求數都列在那裡,Directives 分頁則列出哪些爬蟲抓了你 disallow 的路徑;在這裡擋一隻 bot,系統會自動在 WAF 建一條自訂規則。AWS WAF 的 protection pack 儀表板有 AI Traffic Analysis 分頁。Bunny Shield 會把 bot 判定結果放進 CDN-Bot request header 轉給源站,源站 log 就能直接記下來。
Cloudflare Security Settings 裡 Configure AI bot policies 的三格是你的意圖,Crawlers 分頁的數字是實際結果。兩邊對不上,以實際結果為準。
第二步是 log。要看 CDN 那一層的 log,被 CDN 擋下的請求到不了源站,源站 log 只會看到放行進來的那部分。找出 GPTBot、OAI-SearchBot、ClaudeBot、PerplexityBot 等 AI 爬蟲的請求,看回應碼:
- 200:請求成功進入。
- 403、406、429 或挑戰頁:被 CDN 或 WAF 擋下。
- 只讀取 /robots.txt、內頁沒有任何請求:被 robots.txt 擋下。
user agent 可以偽造,要確認請求確實來自該爬蟲,可比對 OpenAI、Anthropic、Perplexity、Google、Apple、Microsoft 公布的官方 IP 清單。
搜尋與使用者觸發該開放,需要權衡的是 Training
搜尋 bot 與使用者觸發的 bot,是網站在 AI 搜尋與對話中可見度的來源。搜尋 bot 在使用者提問時抓取頁面,讓模型在答案中引用並附上連結;使用者觸發的 bot 則在使用者貼上網址、要求模型讀取時才會出現。封鎖這兩類,網站就不會出現在 AI 搜尋結果中,使用者主動要求讀取時也會失敗。
訓練爬蟲則不帶回連結,影響的是模型內建知識中是否包含你的內容。這類曝光無法被引用、無法量測,要等模型更新才會反映,卻佔了 AI 爬取量的大宗。
Cloudflare 2025 年 8 月的分析:過去 12 個月,AI 爬取有 80% 是為了訓練,搜尋 18%,使用者觸發只有 2%。另一組數據是 crawl-to-refer ratio,也就是 AI 平台每帶回一次點擊轉介需要爬取幾次。Cloudflare Radar 的 2025 年度回顧(資料到 12 月 2 日)裡,Anthropic 最高到 500,000 比 1,OpenAI 3 月最高到 3,700 比 1,Google 最高是 30 比 1。
搜尋影響的是當下、可量測、帶連結的曝光;訓練影響的是未來、無法量測、不帶連結的曝光。兩者的時間尺度與可驗證程度不同,卻常被放在同一個開關底下一起封鎖。
適合封鎖訓練爬蟲的情況有三種:
- 內容本身就是產品:媒體、資料庫、付費報告、線上課程被納入訓練,等於被模型替代,使用者直接向模型取得答案,不再造訪網站。
- 保留定價權:Cloudflare 的 pay per crawl 與 AWS WAF 的 Monetize 動作,已能對 AI 爬蟲回應 402 要求付費,免費提供訓練資料,等於放棄未來在這個市場的定價位置。
- 內容授權不完整:客戶案例、NDA 範圍內的資料、僅取得網站使用授權的圖片素材,被納入訓練後的責任由網站承擔。
三種情況都不符合時,封鎖訓練爬蟲的理由有限。
回到 CDN 後台和 log,確認 OAI-SearchBot、PerplexityBot、Claude-SearchBot 這幾隻爬蟲拿到的是不是 200。被 AI 帶來的流量本來就容易量不準,我在之前那篇寫過分析報表怎麼把它低估;如果連門都沒開,就連被低估的機會都沒有。
告示牌寫得再熱情,門沒開,AI 還是只能站在外面。而那扇門的預設值,多半不是你設的。
資料來源
robots.txt 與各家爬蟲
- RFC 9309|Robots Exclusion Protocol
- OpenAI|Overview of OpenAI Crawlers
- Anthropic|Does Anthropic crawl data from the web
- Perplexity|Perplexity Crawlers
- Google|Google's common crawlers(Google-Extended)
- Apple|About Applebot
- Meta|Meta Web Crawlers
- Microsoft|bingbot.json
Cloudflare
- Your site, your rules: new AI traffic options for all customers(2026-07-01)
- Block AI bots
- Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large(2025-07-01)
- AI Crawl Control|Manage AI crawlers
- AI Crawl Control|Track robots.txt
- AI Crawl Control|Bot reference
- Managed robots.txt
- Detect a Challenge Page response
- Pay per crawl
- Making AI search smarter(2026-07-01)
- The crawl-to-click gap(2025-08-29)
- Cloudflare Radar 2025 Year in Review
Fastly、Akamai、Bunny.net
- Fastly|About Bot Management
- Fastly|Bot Management product description
- Fastly|Using system signals
- Fastly|About agent response codes
- Fastly|About ContentGuard
- Fastly Blog|Take back control: make AI bots play by your rules(2025-04-15)
- Akamai TechDocs|Handle adversarial bots
- Akamai TechDocs|Detection methods
- Akamai TechDocs|New attack insight for AI bot traffic spikes(2026-04-01)
- Bunny.net|Verified Bots
AWS、Google Cloud、Azure
- AWS WAF|Bot Control rule group
- AWS WAF|Bot Control
- AWS WAF|Managed rules changelog
- AWS WAF|Customizing the response for blocked requests
- AWS WAF|CAPTCHA and Challenge actions
- AWS WAF|Dashboards
- Google Cloud Armor|Bot management
- Google Cloud Armor|Security policy overview
- Azure|WAF on Azure Front Door
- Azure|Configure bot protection for Front Door
- Azure|Custom response code for Front Door WAF
Vercel、Netlify
Walt Chuang
ARTOGO 共同創辦人・成長行銷
相關文章
你可能也會喜歡...
你的 GA 偵測到的 AI 流量,可能是被低估 10 倍的數字?
Similarweb 與 Rand Fishkin 用半年 clickstream 追蹤真實用戶旅程:被 ChatGPT 推薦的品牌,七天內被造訪機率是未被推薦對手的 2.5 倍,但 AI-influenced 流量只有 8.8% 走 AI referral 這格(傳統 analytics 唯一量得到的),55.9% 是用戶先問 AI、隔幾天用品牌名 Google 搜、以 organic search 回來。AI 的真實影響被歸因模型系統性低估約十倍,AEO 的下游戰場在品牌搜尋通道。
為什麼 AI 推薦進來的訪客,轉換率是一般流量的 4 倍?
AI Overviews 讓搜尋頂端結果 CTR 跌 61%,但 AI 推薦進來的訪客轉換率是一般 organic 的 4.4 倍。原因是使用者把個人條件交給了 AI,搜尋的形狀從主題相關變成個人條件,內容策略該從覆蓋主題轉向承接條件。
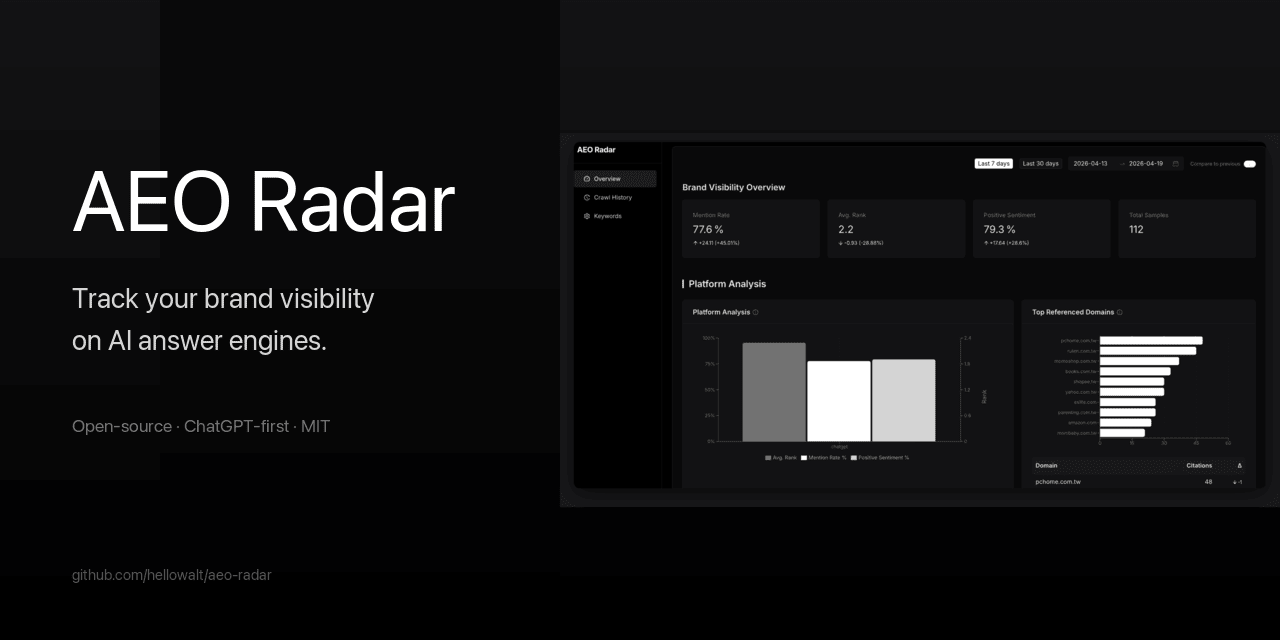
開源 AEO 監測系統:每日自動追蹤你的品牌在 AI 的能見度與評價
AEO Radar 是我把自己在 ARTOGO 用了一個多月的 AEO 監測工具,整套開源出來的版本。每天自動追蹤品牌在 AI 回答裡的提及率、排名、情緒、競品、引用網域。市面上同類工具 Profound 月費台幣 12,800 對還在驗證的中小品牌太重,想讓更多人能先花 20 分鐘跑起來看看,再決定要不要升級付費工具。MIT 授權,改一個檔案、三個指令就能接上自己品牌。